لپتاپ مناسب هوش مصنوعی: کارت گرافیک مهمتره یا NPU؟
برای اجرای مدلهای هوش مصنوعی روی لپتاپ، اول حافظهٔ کارت گرافیک انویدیا مهمه و بعد رم و SSD. NPU و برچسب «AI PC» چقدر ارزش داره؟ اینجا با عدد و منبع جواب میدیم.
در این مقاله
در این مقاله
خلاصه در یک نگاه
- لپتاپ مناسب هوش مصنوعی رو برای اجرای مدلها با این ترتیب انتخاب کنید: کارت گرافیک انویدیا با حافظهٔ کافی، بعد رم، بعد SSD، بعد پردازنده؛ و NPU آخر فهرسته. برای ابزارهای تحتوب کارت گرافیک جدا لازم نیست.
- حافظهٔ گرافیک مال هر نسخهست، نه اسم کارت: RTX 3050 توی موجودی ما هم ۴ گیگ داره هم ۶ گیگ.
- قاعدهٔ سرانگشتی: ۶ گیگ برای شروع، ۸ گیگ برای مدلهای حدود ۸ میلیارد پارامتری؛ سقف موجودی ما ۱۲ گیگه (آبان ۱۴۰۵).
- نشان Copilot+ مایکروسافت NPUی ۴۰ TOPS به بالا میخواد؛ «Ultra» توی اسم پردازنده این رو نشون نمیده.
ادامهٔ خلاصه
- توی دستهٔ لپتاپهای ما اسنپدراگون X نیست، ولی چند سرفیس اسنپدراگونی هم داریم؛ قبل از خرید، همهٔ ابزارهاتون رو چک کنید.
جواب کوتاه: برای اجرای مدلهای هوش مصنوعی روی لپتاپ، اول کارت گرافیک انویدیا و حافظهٔ خودش (VRAM) مهمه، بعد رم و SSD. برچسب «AI PC» و NPU بیشتر به قابلیتهای خودِ ویندوز ربط داره، نه به کار شما با مدلها.
- مبتدی هستید و میپرسید «AI PC» ارزش پول دادن داره یا نه؟ بخش NPU جوابشه.
- دانشجوی رشتهٔ هوش مصنوعی هستید؟ بخش رم و SSD و بخش «مبتدی، دانشجوی رشتهٔ هوش مصنوعی یا اجرای مدل محلی» مال شماست.
- میخواید مدلها رو خودتون روی لپتاپ اجرا کنید؟ بخش حافظهٔ گرافیک همین پایینه.
- فقط مدلهای موجود رو میخواید؟ بخش «بهترین لپتاپ برای هوش مصنوعی از موجودی ما» کارتهاشون رو با قیمت روز نشون میده.
قول نمیدیم فلان مدل روی فلان لپتاپ اجرا بشه. اینکه سرویسهای آنلاین هوش مصنوعی از ایران در دسترسن یا نه رو هم بررسی نمیکنیم؛ بحث ما فقط سختافزاره.
روش کار ما
- عددهای موجودی رو شمردیم، تخمین نزدیم: ۱۸۳ نسخه از ۹۰ محصولِ دستهٔ لپتاپ (بدون سرفیس و استوک)؛ هر «نسخه» یک ترکیب مشخص از رم، حافظه و کارته. آخرین بررسی: آبان ۱۴۰۵.
- ادعاهای فنی از مستندات مایکروسافت، اینتل، کوالکام، llama.cpp، Ollama، انویدیا و scikit-learn اومده؛ منبعها آخر مقالهست.
- ما هیچ لپتاپی رو تست نکردیم؛ عددها از مستندات و موجودی خودمونه. هر جا نوشتیم «قاعدهٔ سرانگشتی» یا «قضاوت ماست»، عددش از منبع نیست.
- ما لپتاپ میفروشیم؛ برای همین میگیم موجودی ما برای چه کسی جواب نیست: کسی که مدلی با بیشتر از ۱۲ گیگ حافظهٔ گرافیک میخواد، یا کسی که فقط ابزار تحتوب استفاده میکنه.
- قیمت توی متن نیست؛ کارتهای محصول قیمت امروز رو نشون میدن.
برای هوش مصنوعی کدوم مشخصهٔ لپتاپ از همه مهمتره؟
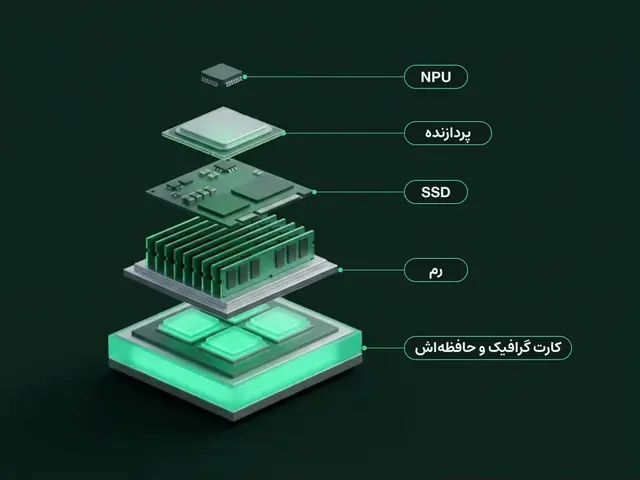
به ترتیب: کارت گرافیک انویدیا با حافظهٔ کافی، بعد رم، بعد SSD، بعد پردازنده؛ NPU آخره. دلیلش سادهست: مدل هوش مصنوعی باید توی حافظهٔ کارت گرافیک جا بشه. اگه جا نشه، بقیهٔ مشخصات فقط تعیین میکنن کار چقدر کند بشه؛ و برای اجرای مدلها روی ویندوز، مسیر سرراستتر معمولاً کارت انویدیاست.
پنج مشخصه به ترتیب اهمیت
مشخصه | چرا اینجاست | چی باید ببینید |
|---|---|---|
کارت گرافیک و حافظهاش | مدل باید توی حافظهٔ کارت جا بشه | کارت انویدیا و حافظهٔ گرافیکِ همون نسخه |
رم | وقتی مدل از کارت سر بره، بخشیش روی رم میشینه | رمی که کنار مدل، ویندوز و مرورگر رو هم نگه داره |
SSD | فایل هر مدل چند گیگ تا چند ده گیگه | ظرفیت برای چند مدل و دیتاست |
پردازنده | وقتی مدل روی کارت میشینه، معمولاً گلوگاه نیست (قضاوت ماست) | ردهٔ متناسب با کارت، نه گرونترین |
NPU | قابلیتهای خودِ ویندوز و کارهای کممصرف | اگه بود خوبه؛ دلیل خرید نیست |
چرا انویدیا؟ CUDA پلتفرمِ خودِ انویدیاست، و Ollama (برنامهای که مدلها رو روی کامپیوتر خودتون اجرا میکنه) برای کارتهای انویدیا compute capability ۵٫۰ به بالا (نسل CUDA کارت) و درایور ۵۵۰ یا جدیدتر میخواد. AMD و Intel ناممکن نیستن (llama.cpp مسیرهای HIP و SYCL داره)، ولی فهرست AMD روی ویندوز توی مستندات Ollama فقط چند کارت Radeon RX 7000 و Radeon PRO رو نام میبره و از لپتاپ حرفی نمیزنه. مستندات میگه پشتیبانی بیشتری از راه Vulkan هم هست، ولی فهرست مشخصی نداره؛ برای مبتدی مسیر نامطمئنتریه.
توی موجودی ما ۷۷ نسخه از ۱۸۳ نسخه (حدود ۴۲٪) کارت انویدیا دارن. اینها گزینهٔ اصلی شما هستن، و همهٔ محصولاتشون رو توی دستهٔ لپتاپهای گیمینگ میبینید.
و NPU؟ آخره، چون برنامه باید مخصوص خودش نوشته شده باشه تا ازش استفاده کنه؛ توضیح کاملش توی بخش NPU هست. اگه برنامهنویسی اولویتتونه، قبلش راهنمای لپتاپ مناسب برنامهنویسی رو ببینید؛ اون هم یک بخش کوتاه دربارهٔ هوش مصنوعی داره و اینجا عمیقتر میریم. اولین سؤال بعدی حافظهٔ گرافیکه: چند گیگ؟
چند گیگ حافظهٔ گرافیک برای اجرای مدلهای هوش مصنوعی لازمه؟
قاعدهٔ سرانگشتی: مدل باید با کمی جا برای متنِ گفتگو توی حافظهٔ کارت بشینه. ۶ گیگ برای شروع و مدلهای کوچک، ۸ گیگ برای مدلهای حدود ۸ میلیارد پارامتری، و ۱۲ گیگ برای حدود ۱۴ میلیارد. اینها تخمینه، نه تضمین؛ و بالاتر از ۱۲ گیگ توی موجودی ما نیست.
حجم مدل تقریباً یعنی تعداد پارامترها ضربدر بیتهای هر وزن. اندازهٔ یک مدل ۸ میلیاردی (Llama 3.1 8B) توی مستندات llama.cpp برای چند جور فشردهسازی اومده؛ پس فشردهسازی دست شماست. سه نمونه:
- Q4_K_M: ۴٫۵۸ گیبیبایت (GiB)
- Q8_0: ۷٫۹۵ گیبیبایت
- F16 (اصلاً فشرده نشده): ۱۴٫۹۶ گیبیبایت
(یک GiB حدود ۱٫۰۷ گیگابایته؛ Ollama عددهاش رو گیگابایت مینویسه.)
گفتگو هم توی حافظه میشینه. طول متنی که مدل همزمان میبینه (context) هزینهٔ حافظه داره: پیشفرض Ollama روی کارتهای زیر ۲۴ گیگ ۴۰۹۶ توکنه (توکن یعنی تکههای کوچک متن) و context بزرگتر حافظهٔ بیشتری میخواد.
جا نشه چی؟ Ollama بخشی از مدل رو توی رم سیستم میذاره و نسبت تقسیم بین پردازنده و کارت رو درصدی نشون میده (مثلاً ۴۸٪ و ۵۲٪). کار میکنه، ولی کندتر.
چه مدلی کجا جا میشه؟ (تخمین، نه تضمین)
حافظهٔ گرافیک | نمونهٔ اندازهٔ دانلود در Ollama (گیگابایت) | معمولاً چطور جا میشه | موجودی ما (آبان ۱۴۰۵) |
|---|---|---|---|
۴ گیگ | qwen3 4b: ۲٫۵ | فقط مدل کوچک، با جای کم برای گفتگو | ۳ نسخه (یک محصول) |
۶ گیگ | qwen3 4b: ۲٫۵؛ llama3.1 8b: ۴٫۹ | مدل کوچک راحت؛ ۸ میلیاردی تنگه | ۲۸ نسخه |
۸ گیگ | llama3.1 8b: ۴٫۹؛ qwen3 8b: ۵٫۲ | مدل حدود ۸ میلیارد پارامتری | ۴۰ نسخه |
۱۲ گیگ | qwen3 14b: ۹٫۳ | مدل حدود ۱۴ میلیارد پارامتری | ۳ نسخه (دو محصول) |
بالاتر از ۱۲ گیگ | qwen3 30b: ۱۹؛ qwen3 32b: ۲۰؛ llama3.1 70b: ۴۳ | توی کارت جا نمیشه؛ بخشی میره روی رم و کندتر میشه | هیچ نسخهای نداریم |
حافظهٔ گرافیک مال نسخهست، نه اسم کارت. توی موجودی ما RTX 3050 سهجور دیده میشه: ۴ گیگ روی ایسوس TUF Gaming A15 (۳ نسخه)، ۶ گیگ روی ۱۵ نسخه (مثلاً TUF Gaming F17)، و ۲ نسخه که حافظهشون ثبت نشده؛ برای اون دو عددی نمیگیم. لنوو LOQ 15 هم بسته به نسخه از RTX 3050 با ۶ گیگ تا RTX 5060 با ۸ گیگ میره. اسمهای نزدیک هم گولتون نزنه: RTX 5070 و RTX 5070 Ti دو کارت متفاوتن؛ توی موجودی ما اولی ۸ و دومی ۱۲ گیگ داره. خودِ RTX 5070 هم یک عدد نیست: انویدیا توی صفحهٔ مقایسهٔ لپتاپهاش اون رو هم با ۱۲ گیگ و هم با ۸ گیگ فهرست کرده، و نسخههای ثبتشدهٔ ما ۸ گیگن. راهنمای حافظهٔ گرافیک برای بازی همین موضوع رو بازتر گفته. جدول بالا ۷۴ نسخه از ۷۷ نسخهٔ انویدیادار رو میشمره و سهتای بقیه حافظهٔ ثبتشده ندارن.
این عددها قول نیست
گفتگوی بلندتر یا فشردهسازی دیگه جدول رو جابهجا میکنه، و اندازهٔ دانلود همهٔ حافظهٔ لازم رو نشون نمیده. آموزش و فاینتیون هم حافظهٔ خیلی بیشتری از اجرای یک مدل میخواد؛ عددش به مدل و روش بستگی داره و اینجا نمیدیم.
توی مدلهای MoE مثل qwen3 30b، فقط بخشی از پارامترها هر بار فعاله؛ برای جا شدن، حجم فایل رو نگاه کنید، نه عدد توی اسم.
یک استثنا: حافظهٔ یکپارچه
گرافیکهای مجتمع حافظهشون رو از همون رم سیستم برمیدارن، و اینکه چه سهمی از رم به گرافیک برسه به دستگاه و تنظیماتش بستگی داره. یک محصول با تراشهٔ Ryzen AI Max+ داریم (ایسوس ROG Flow Z13 GZ302EA، ۳۲ گیگ رم)؛ حافظهٔ گرافیکش ثبت نشده، پس ظرفیتی براش نمیگیم. قبل از خرید بپرسید چند گیگ از رم به گرافیک میرسه.
رم و SSD لپتاپ هوش مصنوعی چقدر باشه؟ ۱۶ گیگ کافیه؟
برای یادگیری و مدلهای کوچک، ۱۶ گیگ رم کافیه (قاعدهٔ سرانگشتی). اگه مدل از حافظهٔ کارت گرافیک بزرگتر باشه و بخشیش روی رم سیستم بشینه، ۳۲ گیگ فرق واقعی میسازه. SSD رو هم کم نگیرید: فایل هر مدل از چند گیگ تا چند ده گیگه، و یک ترابایت راحتتره.
رم دومین عدده، چون بخشی از مدل که از حافظهٔ کارت بیرون بزنه روی رم سیستم میشینه. رم بیشتر این حالت رو قابلتحمل میکنه، نه سریع. ویندوز، مرورگر و ویرایشگر کد هم از همین رم سهم میبرن.
دیسک هم هزینهٔ واقعیه. توی فهرست مدلهای Ollama، نسخهٔ ۸ میلیارد پارامتریِ llama3.1 حدود ۴٫۹ گیگ حجم داره. چند مدل، دیتاست و پروژه کنار ویندوز و برنامهها، ۵۱۲ گیگ رو زود تنگ میکنه.
موجودی ما اینطوریه (۷۷ نسخهٔ انویدیادار از ۱۸۳ نسخهٔ موجود):
- رم: ۱۶ گیگ توی ۵۸ نسخه، ۳۲ گیگ توی ۱۳ نسخه، ۲۴ گیگ توی ۳ نسخه و ۸ گیگ توی ۳ نسخه.
- SSD: ۱ ترابایت توی ۴۶ نسخه، ۵۱۲ گیگ توی ۳۰ نسخه و ۲ ترابایت فقط توی یک نسخه.
هر سه نسخهٔ ۸ گیگ رمِ انویدیادار، RTX 3050 دارن. ۸ گیگ رم کنار کارت انویدیا برای این کار ترکیب ضعیفیه (قضاوت ماست). ارتقای بعدی رم یا SSD رو برای هیچ نسخهای تضمین نمیکنیم؛ ظرفیت هر نسخه رو توی صفحهٔ خودش ببینید.
لپتاپ NPUدار یا AI PC یعنی چی و ارزشش چقدره؟
NPU (واحد پردازش عصبی) یک تراشهٔ تخصصیه که کارهای هوش مصنوعی ویندوز (مثل زیرنویس زنده) رو با مصرف کمتر از CPU و GPU انجام میده. نشان Copilot+ مایکروسافت حداقل ۴۰ TOPS (تریلیون عملیات در ثانیه) میخواد. ولی نرمافزار باید مخصوص NPU نوشته شده باشه تا ازش استفاده کنه؛ پس برای کار شما با مدلها امتیازِ جانبیه، نه دلیل خرید.
مایکروسافت توی صفحهٔ Copilot+ PC از Click to Do، جستوجوی بهتر ویندوز و زیرنویس زنده اسم میبره؛ هیچکدوم اجرای مدلهای خودتون نیست.
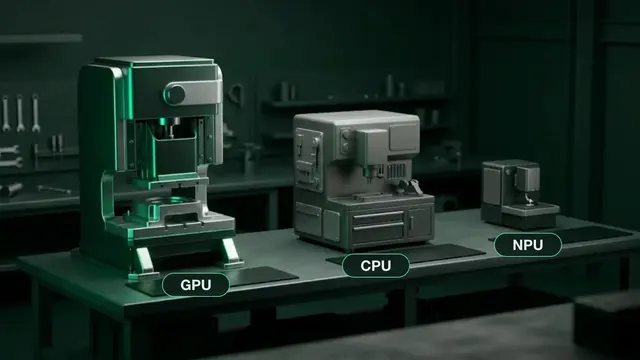
راهنمای توسعهدهندهٔ مایکروسافت هم Intel Core Ultra 200V و AMD Ryzen AI 300 رو نام میبره. ولی «Core Ultra» توی اسم پردازنده فقط یعنی NPU داره، نه لزوماً Copilot+: صفحهٔ خود اینتل برای Core Ultra 9 275HX عدد ۱۳ TOPS (Int8) رو مینویسه و برای Core Ultra 7 256V عدد ۴۷ رو.
شکاف اصلی نرمافزاره. مایکروسافت میگه مدلها باید برای NPU به فرمت عددی کوچکتر (مثل INT8) تبدیل بشن. توی README پروژهٔ llama.cpp هم راههای NPU مخصوص هر سازندهست (مثلاً Hexagon برای اسنپدراگون)، و راه اینتل (OpenVINO) هنوز کامل نشده. یعنی طبق همین فهرست، llama.cpp فعلاً راه آمادهای برای NPUی اینتل یا AMD نداره.
چیزی که توی موجودی خودمون میبینیم
- ۴۴ نسخه از ۱۸۳ نسخهٔ موجود (حدود ۲۴٪) پردازنده با برچسب NPU دارن (Core Ultra یا Ryzen AI)؛ فقط ۱۴ تاشون کارت انویدیا هم دارن و ۳۰ تا ندارن.
- طبق عددهای منتشرشدهٔ سازندهها، حدود ۱۸ تا از این ۴۴ نسخه به ۴۰ TOPS میرسن و حدود ۲۶ تا روی ۱۳ TOPS یا کمتر میمونن. «حدود» میگیم چون صفحهٔ خود سازنده رو برای چند تراشه (مثل Core Ultra 7 355 و Ryzen AI) ندیدیم.
- هر ۱۴ نسخهٔ انویدیادار توی گروه دومه. یعنی لپتاپهایی که به آستانهٔ Copilot+ میرسن و لپتاپهای انویدیادارِ ما، عملاً دو گروه جدا از همن.
پس NPU کجا بهدرد میخوره؟ توی یک لپتاپ نازک و سبک با باتری خوب. اگه همچین دستگاهی میخواید و NPU هم داره، خوبه؛ فقط برای خودِ NPU پول اضافه ندید. نمونهش رو بین لپتاپهای موجود فروشگاه پیدا میکنید؛ ستون اولِ جدول مقایسهٔ پایینتره. یک گروه دیگه از لپتاپهای NPUدار هم هست که بین لپتاپهای ما نیست و فقط توی چند سرفیس میبینیدش: اسنپدراگون X.
Copilot+ و زبان فارسی
مایکروسافت توی صفحهٔ Copilot+ PC مینویسه تجربهها «بسته به دستگاه و منطقه» فرق میکنن و ممکنه نیاز به بهروزرسانی داشته باشن. جستوجوی بهتر ویندوز برای چند زبان منتخب (انگلیسی، چینی سادهشده، فرانسوی، آلمانی، ژاپنی، اسپانیایی) بهینه شده و فارسی توی این فهرست نیست؛ صفحه نمیگه فقط همینها پشتیبانی میشن. ما قابلیتها رو روی دستگاه فارسیزبان آزمایش نکردیم؛ برای قابلیتی که میخواید، زبان و منطقهٔ خودتون رو از مایکروسافت چک کنید.
لپتاپ اسنپدراگون X (ویندوز روی ARM) برای هوش مصنوعی چطوره؟
لپتاپهای اسنپدراگون X (ویندوز روی ARM) طبق بروشور کوالکام برای X Elite، NPUای تا ۴۵ TOPS دارن، ولی برای ابزارهای هوش مصنوعی مسیرشون باریکتره. برنامههای x64 با شبیهساز اجرا میشن، هرچی راهانداز جدا بخواد باید نسخهٔ ARM64 داشته باشه، و گرافیکشون Adreno هست، نه انویدیا، پس CUDA ندارن. توی دستهٔ لپتاپهای ما نیست؛ فقط چند مدل سرفیس اسنپدراگونی داریم.
البته چیزهای زیادی روش اجرا میشه. ویندوز ۱۱ روی ARM برنامههای x86 و x64 رو شبیهسازی میکنه (Prism، توی ویندوز ۱۱ نسخهٔ 24H2) و مستند llama.cpp هم Snapdragon X Elite رو پشتیبانیشده فهرست کرده.
محدودیتش رو هم خود مایکروسافت نوشته: شبیهسازی فقط برنامههای معمولی (کد حالت کاربر) رو پوشش میده، نه راهاندازها رو، و هر جزء حالت هسته (کدِ سطح سیستم) باید برای ARM64 ساخته شده باشه.
توی ۱۸۳ نسخهٔ دستهٔ لپتاپ ما اسنپدراگون یا کوالکام صفره. سرفیسهای اسنپدراگونی توی دستهٔ سرفیس و بخش استوک جدا هستن و با هیچکدوم تجربهٔ مستقیمی نداریم؛ حرف این بخش از مستنداته، نه از تجربه. برای PyTorch روی Adreno منبع معتبری پیدا نکردیم، پس کار میکنه یا نه رو نمیگیم. دربارهٔ سرفیسها توی راهنمای سرفیس یا لپتاپ جدا نوشتیم.
قبل از خرید اسنپدراگون، ابزارهاتون رو یکییکی چک کنید
- نسخهٔ ARM64 هر ابزارتون هست، یا فقط با شبیهساز اجرا میشه؟
- ابزارتون راهانداز یا جزء حالت هسته نصب میکنه؟
- دورهای که دنبال میکنید فرض میکنه CUDA دارید؟
مبتدی، دانشجوی رشتهٔ هوش مصنوعی یا اجرای مدل محلی؛ کدوم لپتاپ؟
فقط با ابزارهای آماده کار میکنید؟ کارت گرافیک جدا لازم ندارید. دانشجو با ۱۶ گیگ رم شروع میکنه و کارت انویدیای ۶ گیگی وقتی مهم میشه که سراغ یادگیری عمیق بره. برای اجرای مدل، ۸ تا ۱۲ گیگ حافظهٔ گرافیک و ۳۲ گیگ رم منطقیتره (قاعدهٔ سرانگشتی)؛ مدلهای حدود ۲۰ گیگ و بیشتر با نسخههای موجود جواب نمیدن.
مبتدی: فقط میخوام با ابزارهای آماده کار کنم
اگه ابزار روی سرور اجرا میشه و شما فقط توی مرورگر کار میکنید، لپتاپ یک مرورگر خوب و رمِ کافی میخواد و بس. یک لپتاپ سبک با NPU هم مشکلی نداره. کارت گرافیک جدا برای این کار چیزی اضافه نمیکنه.
دانشجوی رشتهٔ هوش مصنوعی
ابتدای مسیر، یعنی پایتون و نوتبوک و یادگیری ماشین کلاسیک، بیشتر روی CPU اجرا میشه. scikit-learn توی پرسشهای متداولش میگه یادگیری عمیق جزو کار این کتابخونه نیست و برای اجرای کارآمدش GPU لازمه. از وقتی PyTorch و یادگیری عمیق شروع بشه، کارت انویدیا با ۶ گیگ حافظه یا بیشتر معنی پیدا میکنه (قاعدهٔ سرانگشتی).
- رم ۱۶ گیگ و SSD بین ۵۱۲ گیگ تا ۱ ترابایت.
- از مدرس بپرسید درسها کدوم فریمورک و کدوم نسخهٔ CUDA رو فرض گرفتن.
برنامهنویسی رو توی راهنمای لپتاپ مناسب برنامهنویسی جدا بررسی کردیم.
اجرای مدل محلی و آزمایش
با Ollama یا llama.cpp مدل رو روی خودِ لپتاپ اجرا میکنید. اینجا ۸ تا ۱۲ گیگ حافظهٔ گرافیک، ۳۲ گیگ رم و ۱ ترابایت SSD منطقیتره (قاعدهٔ سرانگشتی).
از مدلهایی که حجم دانلودشون حدود ۲۰ گیگ و بیشتره، لپتاپهای موجود ما جواب نیستن: بالاترین حافظهٔ گرافیکِ ثبتشده توی موجودی ما ۱۲ گیگه، و qwen3 با ۳۰ میلیارد پارامتر ۱۹ گیگ حجم داره.
قاعدهٔ آخر یک خطه: برای سنگینترین کاری که واقعاً قراره انجام بدید بخرید، نه برای برچسبِ روی بدنه.
بهترین لپتاپ برای هوش مصنوعی از موجودی ما کدومه؟
سه پله از موجودی ما: کارت ۶ گیگی برای شروع، ۸ گیگی با ۳۲ گیگ رم برای مدلهای محلی، و ۱۲ گیگی که توی آخرین بررسی (آبان ۱۴۰۵) سقف موجودی ماست. قیمت و موجودیِ روز رو خودِ کارتها نشون میدن؛ ما فقط توضیح میدیم هر پله برای چه کاریه.
- ۶ گیگ، برای شروع: اچپی Victus 15 با RTX 4050، ۶ گیگ حافظهٔ گرافیک و ۱۶ گیگ رم. برای دانشجویی که تازه به PyTorch رسیده و با مدلهای کوچک کار میکنه؛ برای مدلهای بزرگتر جاش کمه.
- ۸ گیگ، برای مدل محلی: ایسوس TUF Gaming F16 با RTX 5060، ۸ گیگ حافظهٔ گرافیک و ۳۲ گیگ رم (تنها نسخهٔ موجودش همینه). برای امتحان مدلهای حدود ۸ میلیارد پارامتری با Ollama (حسابش توی جدول بخش حافظهٔ گرافیکه).
- ۱۲ گیگ، سقف موجودی: ایسوس ROG Strix G16 یا اماسآی Vector 16 HX AI، هر دو با RTX 5070 Ti و ۱۲ گیگ حافظهٔ گرافیک. نسخهٔ ۳۲ گیگ رم فقط روی ROG Strix G16 هست و برای مدل محلی منطقیتره؛ قیمت دو کارت رو کنار هم ببینید. برای کسی که میخواد از مرز ۸ میلیارد رد بشه و به حدود ۱۴ میلیارد برسه؛ حسابش همون جدوله.
سه پله، چهار لپتاپ از موجودی
هر کارت یکی از نسخههای همون لپتاپ رو نشون میده: نسخهای که قیمتش پایینتره. ROG Strix G16 نسخهٔ ۳۲ گیگ رم هم داره و Victus 15 نسخهٔ ۱ ترابایتی؛ نسخهٔ دلخواه رو توی صفحهٔ محصول انتخاب کنید.

لپتاپ گیمینگ اچپی Victus 15 FA2082WM
RTX 4050Core i5۱۶ گیگ رم

لپتاپ گیمینگ ایسوس TUF Gaming F16 FX608JMR
RTX 5060Core i7۳۲ گیگ رم

لپتاپ گیمینگ ایسوس ROG Strix G16 G615LR
RTX 5070 TiCore i9۱۶ گیگ رم

لپتاپ گیمینگ اماسآی Vector 16 HX AI
RTX 5070 TiCore i9۱۶ گیگ رم
قیمت و موجودی همین حالا از فروشگاه خوانده شده.
بین RTX 5050 و RTX 5060 مردد هستید؟ توی نسخههایی که حافظهٔ گرافیکشون ثبت شده، هر دو ۸ گیگ دارن؛ پس برای هوش مصنوعی فرقشون ظرفیت نیست، سرعته. مقایسهشون رو توی RTX 5050 یا 5060؟ نوشتیم.
اگه مدلی که میخواید بزرگتر از ۱۲ گیگ حافظهٔ گرافیکه، نسخههای موجود جواب نمیدن. قبل از خرید هم حافظهٔ گرافیک و رمِ نسخهٔ انتخابی رو توی صفحهٔ محصول دوباره ببینید.
NPU یا کارت گرافیک؟ کنار هم
| مشخصه | ایسوس Zenbook S14 UX5406SA | اچپی Victus 15 FA2082WM | ایسوس TUF Gaming F16 FX608JMR | ایسوس ROG Strix G16 G615LR |
|---|---|---|---|---|
| قیمت روز | ۳۲۷٬۷۰۰٬۰۰۰ تومان | ۲۷۵٬۶۰۰٬۰۰۰ تومان | ۴۴۷٬۸۰۰٬۰۰۰ تومان | ۷۱۶٬۲۰۰٬۰۰۰ تومان |
| پردازنده | Intel Core Ultra 7 256V | Intel Core i5-13420H | Intel Core i7-14650HX | Intel Core Ultra 9 275HX |
| کارت گرافیک | Intel Arc | NVIDIA RTX 4050 | NVIDIA RTX 5060 | NVIDIA RTX 5070 Ti |
| رم | ۱۶ گیگابایت | ۱۶ گیگابایت | ۳۲ گیگابایت | ۱۶ گیگابایت |
| حافظهٔ داخلی | ۵۱۲ گیگابایت | ۵۱۲ گیگابایت | ۱ ترابایت | ۱ ترابایت |
قبل از خرید لپتاپ هوش مصنوعی چی رو چک کنم؟
اگه میخواید مدل اجرا کنید یا سراغ یادگیری عمیق برید، پنج چیز رو چک کنید: حافظهٔ گرافیکِ همون نسخه (نه اسم کارت)، کارت انویدیا، رم ۱۶ یا ۳۲ گیگ، SSD حداقل ۵۱۲ گیگ و پشتیبانی ابزارهاتون از همون سختافزار. اگه فقط ابزار تحتوب استفاده میکنید، مرورگر و رمِ کافی بسه. توی هر دو حالت NPU دلیل خرید نیست.
- حافظهٔ گرافیکِ همون نسخه، نه اسم کارت (بخش حافظهٔ گرافیک).
- کارت انویدیا، اگه مدل اجرا میکنید یا یادگیری عمیق کار میکنید (بخش ترتیب اهمیت).
- رم ۱۶ یا ۳۲ گیگ (بخش رم و SSD).
- SSD حداقل ۵۱۲ گیگ.
- پشتیبانی ابزارهای موردنیازتون (بخش NPU و اسنپدراگون).
لپتاپ هوش مصنوعی چیه و فرقش با لپتاپ معمولی چیه؟
یک برچسب تبلیغاتیه که بیشتر روی لپتاپهای دارای NPU میزنن. برای کار با مدلها حافظهٔ کارت گرافیک مهمتره، و ابزارهای تحتوب رو هر لپتاپی توی مرورگر اجرا میکنه؛ پس لازم نیست برای اسمش پول اضافه بدید.
لپتاپ مناسب هوش مصنوعی و برنامهنویسی چه مشخصاتی داره؟
حداقل ۱۶ گیگ رم و ۵۱۲ گیگ SSD (قاعدهٔ سرانگشتی). کارت انویدیا فقط وقتی لازمه که بخواید مدل آموزش بدید یا اجرا کنید؛ برای برنامهنویسی معمولی لازم نیست.
برای اجرای مدلهای محلی ۸ گیگ حافظهٔ گرافیک کافیه؟
برای مدلهای حدود ۸ میلیارد پارامتری با context متوسط، بله (قاعدهٔ سرانگشتی)؛ حجم دانلودشون حدود ۵ گیگه. برای ۱۴ میلیارد به بالا نه: qwen3 14b حدود ۹٫۳ گیگه و از ۸ گیگ بیرون میزنه.
برای کار با CUDA باید لینوکس نصب کنم؟
لزوماً نه. انویدیا CUDA روی WSL 2 (لینوکسِ داخل خود ویندوز) رو برای ویندوز ۱۱ و ویندوز ۱۰ نسخهٔ 21H2 به بعد مستند کرده. فقط درایور ویندوزی لازمه؛ داخل WSL درایور لینوکسی نصب نکنید.
ایسوس برای هوش مصنوعی بهتره یا لنوو؟
برند مشخصات نیست؛ حافظهٔ گرافیک و رمِ هر نسخه رو جدا بخونید. توی آخرین بررسی (آبان ۱۴۰۵) از ۷۷ نسخهٔ انویدیادارِ ما ۲۷ تا ایسوس، ۲۱ تا لنوو، ۱۷ تا اچپی، ۶ تا ایسر و ۶ تا اماسآی بود؛ این عددها عوض میشن.
منابع (۱۷)
- Copilot+ PCs developer guideMicrosoft Learn
- Copilot+ PCsMicrosoft
- How emulation works on ArmMicrosoft Learn
- Intel Core Ultra 9 Processor 275HX specificationsIntel
- Intel Core Ultra 7 Processor 256V specificationsIntel
- Snapdragon X Elite Product Brief (REV F)Qualcomm
- llama.cpp READMEggml-org / GitHub
- llama.cpp quantize tool READMEggml-org / GitHub
- llama.cpp OpenCL backend (Adreno)ggml-org / GitHub
- Ollama FAQOllama
- Ollama context lengthOllama
- Ollama GPU supportOllama
- Ollama library: llama3.1Ollama
- Ollama library: qwen3Ollama
- Compare GeForce RTX laptopsNVIDIA
- CUDA on WSL User GuideNVIDIA
- scikit-learn FAQscikit-learn
قبل از خرید بپرسید
اگه بعد از خوندن این مقاله هنوز مطمئن نیستید کدوم مدل به کارتون میخوره، از ما بپرسید؛ تماس بگیرید یا توی واتساپ بنویسید.
نشانی: تهران، پاساژ چارسو، زیر همکف، واحد A10ساعت کار: هر روز، ۱۰:۳۰ تا ۲۰:۰۰
بیشتر بخوانید
این مطلب به محصولات موجود در فروشگاه ما هم اشاره میکند؛ انتخابها بر پایهٔ همان بررسی و آزمایشی است که در فروشگاه انجام میدهیم.